Una tarea puede durar horas y no necesitar el mismo modelo para todo. Sacar fechas de unos documentos y decidir qué recomendar después de leerlos son trabajos bastante distintos.
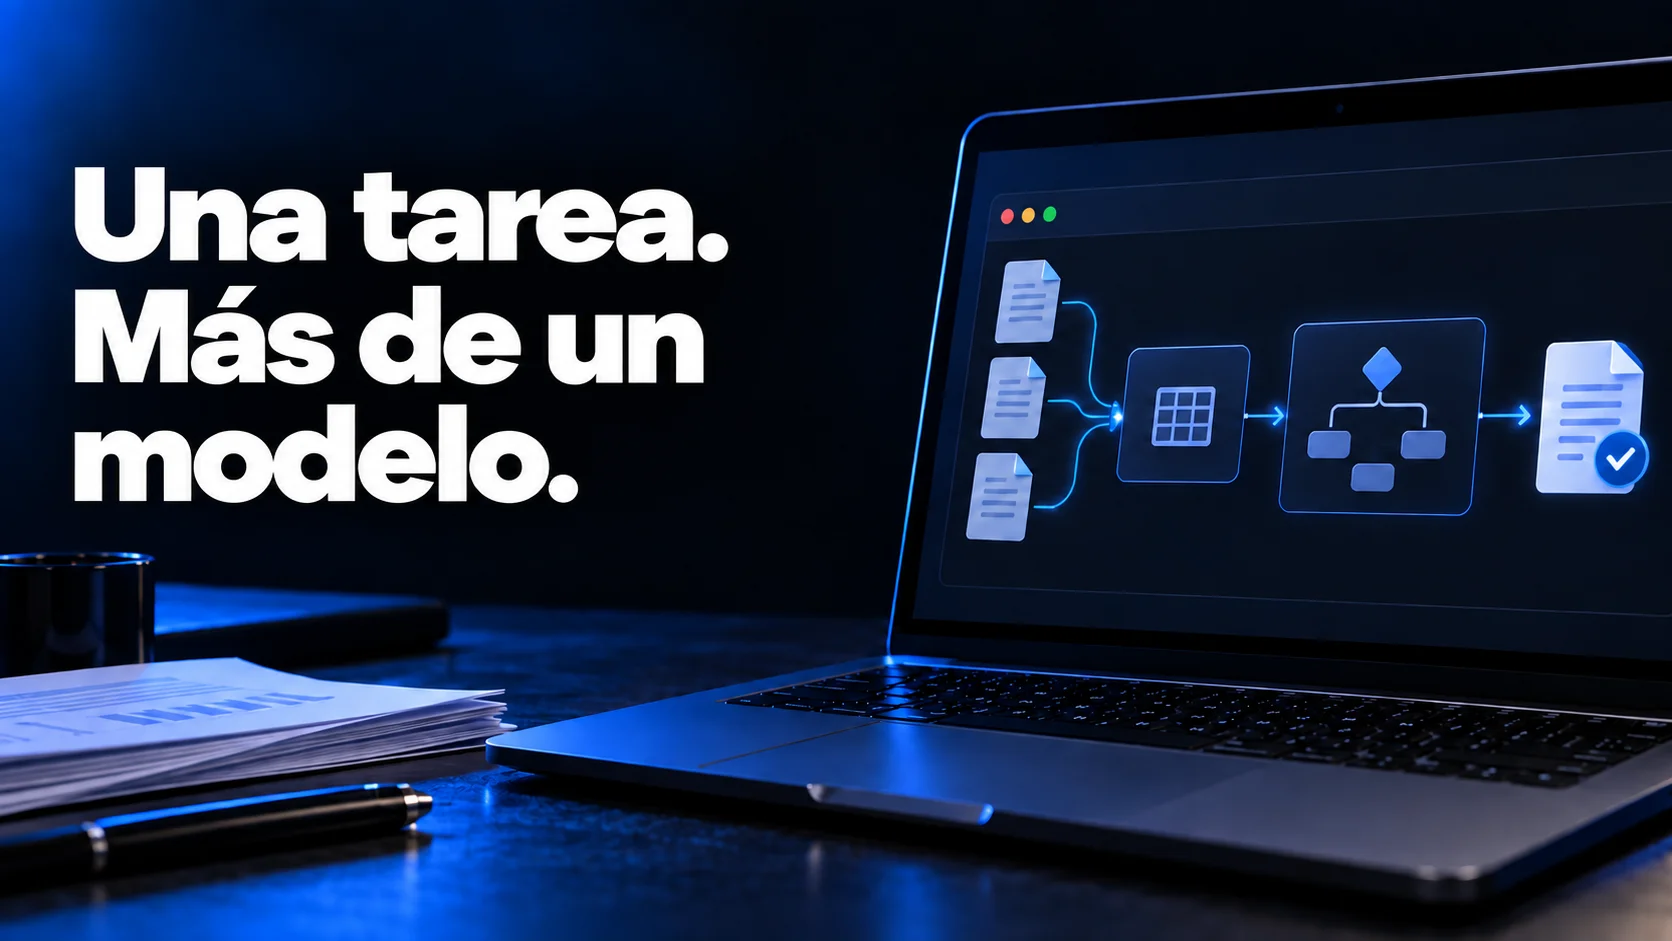
50 entrevistas y tres mejoras
Por ejemplo, imagina que tienes 50 entrevistas con clientes y necesitas elegir tres mejoras para el producto. El subagente extractor usaría un modelo pequeño para reunir en una tabla los problemas que mencionan los clientes, con citas y fuentes. El subagente revisor usaría un modelo más potente para escribir y revisar las recomendaciones, resolver dudas y comprobar las contradicciones.
Cargando el diagrama…
Guarda los resultados al terminar cada lote. Así, si la tarea se corta a mitad, puedes seguir desde donde se quedó.
Pruébalo con tus archivos
Los dos subagentes ya tienen su modelo, razonamiento e instrucciones.
| Subagente | Modelo | Razonamiento |
|---|---|---|
| extractor.es.toml | gpt-6-luna | medium |
| revisor.es.toml | gpt-6.1-sol | high |
Copia y pega el prompt en tu proyecto. El agente descargará los archivos y configurará los subagentes. Necesitas acceso a los dos modelos y una herramienta compatible con este formato de agentes.
Descarga estos TOML y configura los subagentes en este proyecto.
Guárdalos donde corresponda y conserva la configuración anterior.

extractor
https://gist.githubusercontent.com/idirouhab/1f8e255c22758725f87c75841a645029/raw/97b2d636ee34eeac9aeab60c97caad21519e570a/extractor.es.toml

revisor
https://gist.githubusercontent.com/idirouhab/ad438cc612d79a1775328f07dc827d96/raw/a2e61f5ef9c2abb201a17f05c01ee7e8c4ee9b91/revisor.es.toml

Lee los archivos y configura los subagentes con sus valores de
name, model, model_reasoning_effort, sandbox_mode y developer_instructions.
Aplica esos valores al lanzarlos. Si no puedes, para y dime qué falta.

Antes de analizar los documentos, pregúntame qué decisión quiero tomar.

Define las columnas y divide los documentos en lotes de cinco.
Lanza extractor para cada lote, por turnos.
Dale los archivos de su lote, la decisión, las columnas
y una ruta de salida distinta para su tabla.

Cuando terminen todos, lanza revisor con las tablas,
las fuentes, la decisión y la ruta recomendaciones.md.
Pídele tres mejoras respaldadas por las entrevistas.

Anota los lotes completados y sus tablas en progreso.md.
Si la tarea se interrumpe, continúa con los pendientes.
Al terminar, indica el modelo y el razonamiento de cada agente.
Yo probaría con cinco documentos antes de darle los 50. Mira en qué se equivoca, cuánto tarda y cuánto cuesta. Si tienes que estar corrigiendo al modelo pequeño todo el rato, poco estás ganando.
Más sobre cómo elegir un modelo.
Conversación
Comentarios
No hay comentarios publicados