Uno de los mejores avances del siglo XXI ha sido traer la inteligencia artificial a nuestras casas. Ya no solo para ayudarnos a preguntarle a ChatGPT cuál es la altura de un caniche, sino para usarla en tareas un poco más útiles (no mucho más) como ayudarme a hacer mejor mi trabajo.
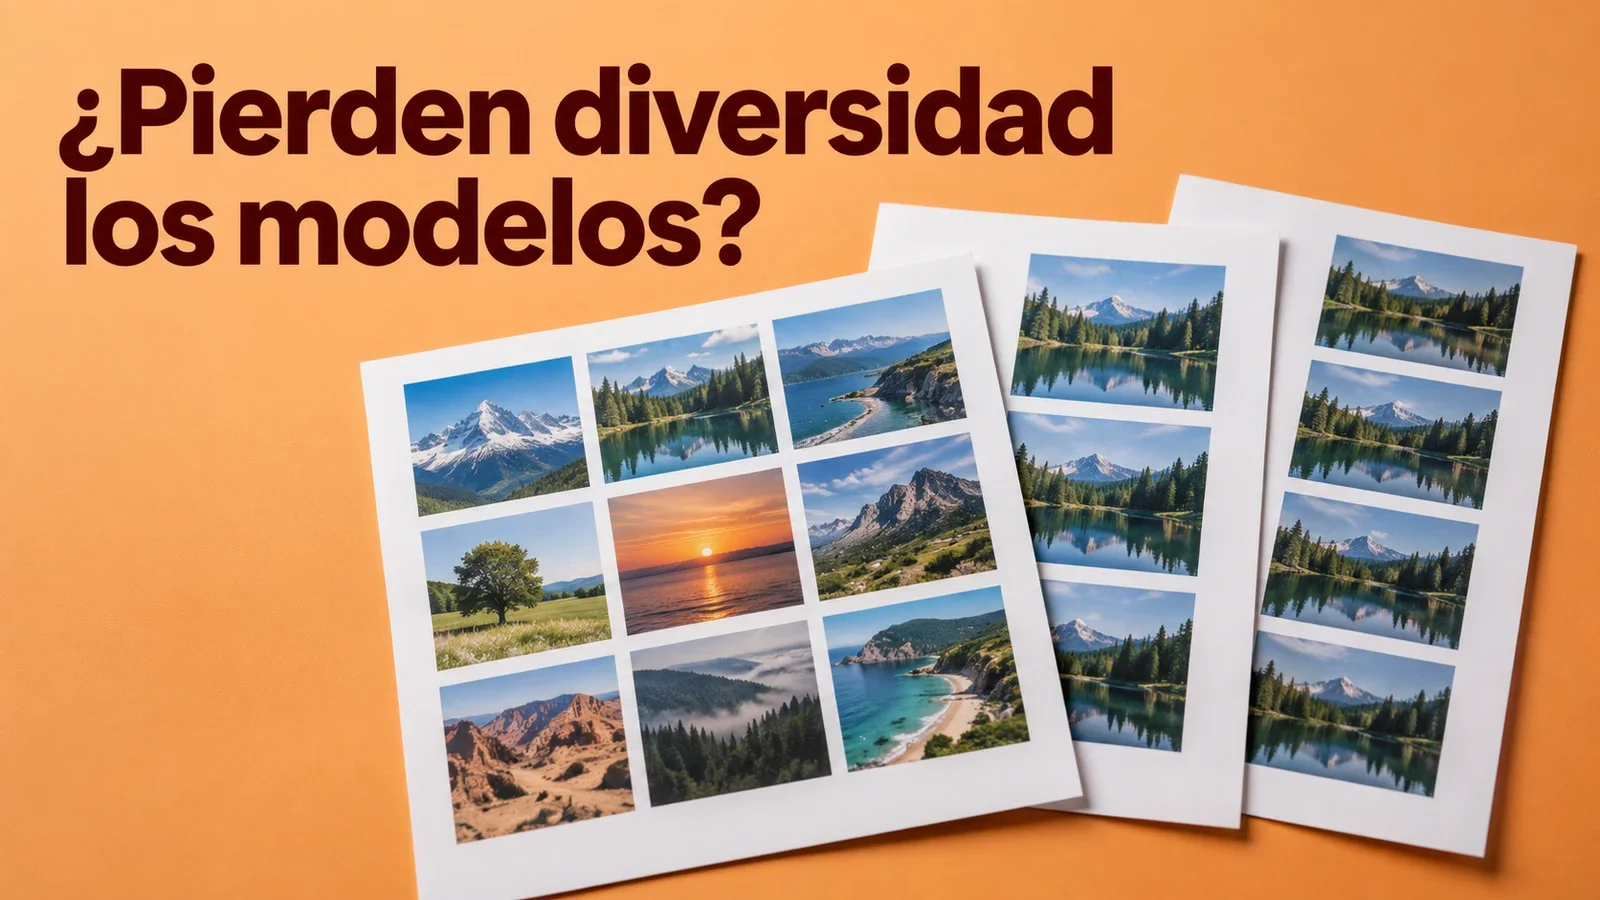
Pero en este post no vengo a hablarte de automatizaciones, sino de la calidad de los datos que se usan para entrenar a los ya famosos LLM. Si no sabes lo que es un LLM te recomiendo que veas este vídeo de Dot CSV antes de continuar.
😡🤬 Los malditos emojis 🤯🚀
¿Cuántos emojis han aparecido de repente en los posts de LinkedIn, Facebook y demás redes sociales de los pseudocreadores de contenido? ¿Cuántos de ellos crees que son generados?
Lo de los emojis es una observación mía, no un detector de textos escritos por IA. Contarlos no demuestra quién escribió un post ni si entró en un conjunto de entrenamiento. Lo que me preocupa es reutilizar contenido generado sin comprobar su origen y su calidad.
IA que se entrena con IA
Imagina un juego de espejos: un modelo genera un post, alguien lo publica y un conjunto de entrenamiento posterior lo incluye. Es un posible bucle, no una descripción comprobada de lo que ocurre con cada publicación. Publicarlo o indexarlo en un buscador no demuestra que un modelo se haya entrenado con él.
Yo llamo a ese riesgo autofagia digital. La pregunta de investigación es qué ocurre cuando se reutilizan repetidamente muestras generadas para entrenar.
El colapso del modelo
Ese riesgo tiene un nombre: colapso del modelo. Me preocupa que entrenar modelos con contenido generado por otros modelos, sin cuidar la calidad y la diversidad de los datos, termine produciendo resultados 💩.
El trabajo publicado en Nature en 2024 estudia el entrenamiento recursivo con datos generados y muestra cómo puede perder partes de la distribución original. No establece una regla universal según la cual cinco generaciones provoquen una pérdida del 50 % de diversidad.
Fuentes:
- Comentario sobre la investigación: Science Media Centre
La salvación del ser humano
Al hablar de este tema con Mandip Gosal, mi compañero en n8n en aquel momento, pensamos en el lenguaje hablado como posible fuente de material original.
Es una hipótesis de aquella conversación, no una solución demostrada al colapso del modelo. Las conversaciones humanas y sus transcripciones también necesitan comprobaciones de origen, exactitud e idoneidad antes de usarse como datos de entrenamiento.
¡AYUDA!
Dos cosas que puedes hacer HOY:
- Verifica todo: Dedica cinco minutos más a revisar que los datos sean correctos.
- Aporta tu experiencia única: La IA no ha vivido tu experiencia, úsala.
El problema no es usar IA, es usarla sin pensamiento crítico.
Conversación
Comentarios
No hay comentarios publicados