Construir aplicaciones de IA requiere ingeniería de contexto además de buenas instrucciones: decidir qué información necesita el modelo y qué partes se pueden reutilizar. Una ventana de contexto grande indica capacidad; no demuestra que enviar más información sea útil o barato.
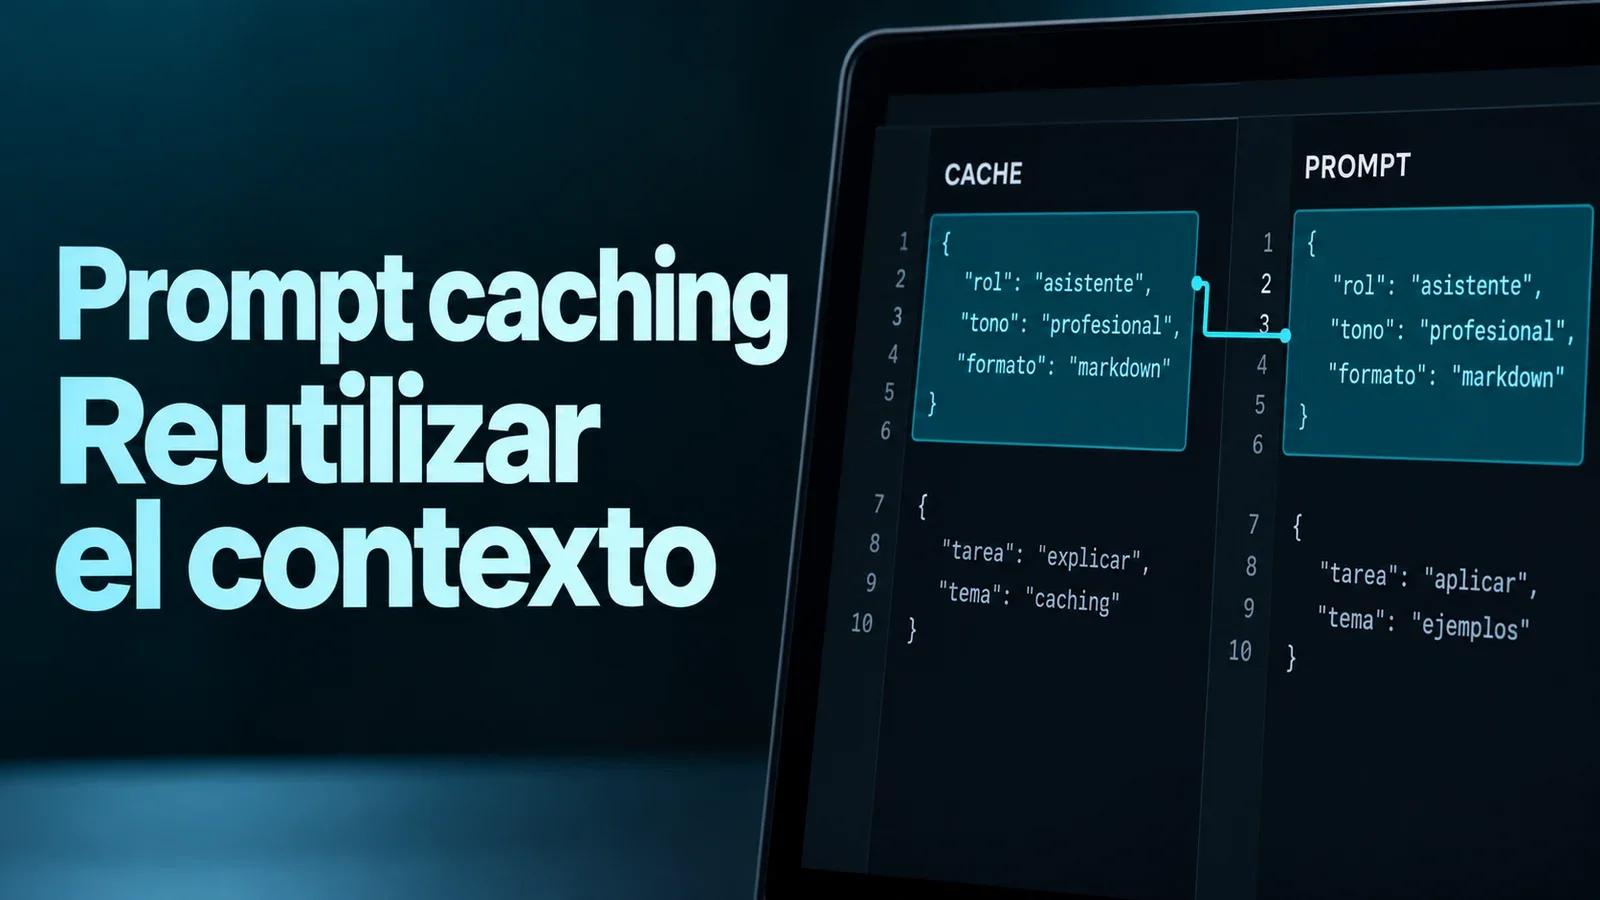
Sin caché de prompts, cada turno en una conversación larga se siente como comprar el mismo libro cinco veces solo para leer cinco capítulos distintos.
Tokens y el matiz de la «capacidad»
Los tokens son unidades de entrada y salida, no un número fijo de palabras. La cantidad depende del tokenizador del modelo, del idioma y del contenido. Una ventana de contexto grande no convierte en gratis la información que envías.
- Capacidad y uso: El límite de contexto es el tamaño del almacén; el sistema procesa la información que realmente envías.
- Reutilización de la caché: Cuando hay un acierto, el proveedor puede reutilizar el procesamiento de un prefijo válido. El resto de la entrada y la salida generada siguen requiriendo trabajo.
- Costes: Los cargos por lectura, escritura, retención y almacenamiento dependen del proveedor y del modelo. Comprueba las tarifas vigentes y los datos de uso de caché de la respuesta antes de asumir un descuento fijo.
Manos a la obra: la estrategia del «prefijo estático»
Para provocar un acierto de caché, vuestro prompt debe estructurarse como un prefijo estático (la parte que no cambia) seguido de un sufijo dinámico (la nueva pregunta).
1. Cachear la «biblioteca de herramientas» (patrón agente)
Si vuestro agente de IA tiene más de 40 herramientas especializadas (funciones), solo las definiciones en JSON pueden ocupar miles de tokens. Si mandáis eso con cada mensaje del usuario, la factura se dispara.
Claude: marca el límite que quieres reutilizar.
Si usas un punto de caché explícito, coloca cache_control en la última herramienta o bloque de contenido que quieras reutilizar, no en la primera herramienta seguida de definiciones que cambian. El ejemplo original contenía un identificador de modelo incorrecto y omitía configuración necesaria; no debe copiarse como una petición lista para ejecutar. Utiliza un modelo compatible y los ejemplos completos de la documentación de caché de Claude, y comprueba la longitud mínima y el uso de lectura de caché del modelo elegido.
2. El «residente a largo plazo» (preguntas y respuestas sobre documentos)
Cuando construís una herramienta de «chatear con un PDF», el documento es la parte estática.
OpenAI: mantén estable el contexto reutilizable. El ejemplo siguiente ilustra el orden, no una petición completa a la API. Coloca el material de referencia antes de las preguntas o fechas que cambian. Los límites admitidos, las longitudes mínimas y la retención dependen del modelo y de la configuración; un prefijo estable no garantiza por sí solo un acierto. Consulta la guía de caché de OpenAI y el uso de entrada en caché que devuelve la respuesta.
# Correcto: primero el contexto, luego la pregunta del usuario
messages = [
    {"role": "system", "content": "You are analyzing the 50,000-token 'Legal_Contract_v2.pdf'. [Full Text Here]"},
    {"role": "user", "content": "What is the termination clause?"}
]
3. La «captura de contexto» (Google Gemini)
Gemini ofrece caché implícita en los modelos compatibles y objetos de caché explícita mediante la API generateContent. Son mecanismos distintos; la API Interactions no admite objetos de caché explícita.
Antes de usar una caché explícita, elige un modelo compatible, comprueba el tamaño mínimo y los costes de retención, y pasa la referencia de la caché al generar la respuesta. El ejemplo original terminaba tras crearla y utilizaba un identificador de modelo sin verificar. Sigue los ejemplos actuales de Gemini para la API que utilices, en lugar de tratar aquel ejemplo parcial como código listo para ejecutar.
Mantén consistente el prefijo reutilizable
Cambiar contenido antes de un límite de caché puede impedir la reutilización desde ese punto. Las reglas, el enrutamiento y la caducidad dependen del proveedor y del modelo; no todo cambio implica procesar la petición completa desde cero. Mide los aciertos reales.
Consejo práctico: Serializa el contenido reutilizable de forma consistente. Normaliza los espacios solo cuando no alteres el significado del documento o del código.
Conversación
Comentarios
No hay comentarios publicados